Wie wird aus einer Angebotsanfrage im PDF-Format ein fundierter Angebotsvorschlag? Unser ORBIS Showcase „Agentische Workflows“ in der SAP Business Data Cloud zeigt, wie sich ausgewählte vertriebliche Teilprozesse neu gestalten lassen. Im Mittelpunkt steht das Zusammenspiel von Informationen aus der Kundenanfrage und strukturierten Geschäftsdaten – mit dem Ziel, den Vertrieb bei der Angebotserstellung gezielt zu unterstützen.
Der dargestellte Lösungsansatz stellt bewusst lediglich den ersten Schritt in Richtung agentischer Vertriebsprozesse dar. Im aktuellen Ausbaugrad werden definierte Prozessschritte durch KI unterstützt automatisiert und Informationen aus unstrukturierten Datenformaten für die Analyse und dialogorientierte KI nutzbar gemacht.
Viele Unternehmen verfügen über eine große Menge an wertvollen strukturierten Daten aus dem Vertriebsbereich und seinem betriebswirtschaftlichen Umfeld. In CRM-, ERP und weiteren operativen Systemen und Datenbanken liegen Kunden-, Material-, Preis-, Angebots-, Auftrags-, Faktura- und Lieferdaten vor, die idealerweise bereits in Business Data Warehouses aufbereitet und konsolidiert und auswertbar gemacht werden. Gleichzeitig existieren darüber hinaus eine Vielzahl von un- oder semistrukturierten Informationen, etwa in PDF-Dokumenten, E-Mails, technischen Spezifikationen, Ausschreibungen, Gesprächsnotizen oder Vertragsunterlagen. Die Informationen beider Datenwelten sind für nachhaltigen Geschäftserfolg relevant, werden jedoch häufig getrennt betrachtet oder nur unzureichend miteinander verknüpft.
Im klassischen Analytics-Ansatz stehen meist strukturierte, auf Stamm- und Belegdaten basierende Informationen im Mittelpunkt. Sie lassen sich recht einfach modellieren, aggregieren und in Berichten auswerten. Für viele operative Entscheidungen reicht das jedoch nicht aus: Ein Vertriebsteam möchte nicht nur retrospektiv historische Angebote analysieren, sondern auch im laufenden Angebotsprozess aktiv unterstützt und durch automatisierbare Schritte entlastet werden.
Hier setzt die SAP Business Data Cloud (BDC) an. Sie führt jegliche Arten von Daten zusammen und schafft dadurch eine vertrauenswürdige breite Datenplattbasis mit semantisch angereicherten Geschäftsdaten für moderne Data- und KI-Szenarien. So wird aus einer Datenplattform ein strategischer Enabler für neue Formen der Prozessunterstützung.
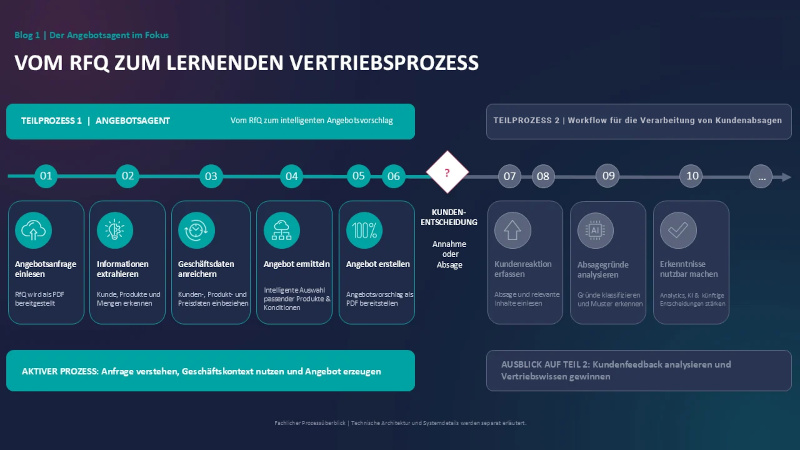
Im ersten Teilprozess übernimmt der Prototyp eines Angebotsagent die automatisierte Verarbeitung einer Angebotsanfrage. Aus einem RfQ im PDF-Format entsteht ein konkreter Angebotsvorschlag.
Im zweiten Teilprozess wertet ein automatisierter Workflow Kundenabsagen aus und macht die gewonnenen Erkenntnisse für die Optimierung künftiger Angebote nutzbar.
Anmerkung: Die in der Folge vorgestellten Prototypen für agentische Workflows bzw. Workflow Automation sollen lediglich die neuen technischen und funktionalen Möglichkeiten der SAP Business Data Cloud verdeutlichen und steht nicht in direkter Konkurrenz zu SAP-Produkten wie bspw. SAP CPQ. SAP CPQ unterstützt klassische, komplexe Angebotsprozesse mit Preislogik, Konfigurationsregeln und Genehmigungsworkflows. Die von uns gebaute Vorstufe soll deutlich machen, wie strukturierte SAP-Daten und unstrukturierte Informationen in einem Lakehouse zusammengeführt werden können und sich dadurch gezielt einzelne ausgewählte vertriebliche Schritte beschleunigt bzw. neugestaltet und Entscheidungen KI unterstützt gezielt verbessert werden.Der Einfachheit halber will ich in der Folge für beide Prototypen den Begriff agentischer Workflow bzw. Workflow nutzen.
Auch wenn auf den folgenden Seiten die beiden agentischen Workflows und der Vertriebsprozess im Mittelpunkt stehen, ist das zugrunde liegende Muster auf viele weitere Bereiche übertragbar. Überall dort, wo strukturierte operative Daten und unstrukturierte Informationen gemeinsam bewertet werden müssen, entstehen ähnliche Potenziale. Im Service könnten agentische Workflows technische Meldungen, Wartungshistorien, Ersatzteildaten und Dokumentationen zusammenführen. Im Einkauf könnten Lieferanteninformationen, Verträge, Bestellungen und Marktinformationen kombiniert werden. In Finance könnten strukturierte Buchungsdaten mit Verträgen, Belegen oder Kommentaren angereichert werden. In der Supply Chain könnten operative Bestands- und Lieferdaten mit externen Signalen und unstrukturierten Informationen verknüpft werden. Die Möglichkeiten sind schier grenzenlos.
Der strategische Wert liegt also nicht in einem einzelnen Use Case. Unsere Show Cases sind ein Einstiegspunkt, um ein neues Denken, einen Perspektivwechsel zu veranschaulichen: Prozesse werden datengetriebener, kontextreicher und intelligenter, wenn Unternehmen ihre Datenbasis konsequent für moderne KI- und Analytics-Szenarien öffnen. Unser Showcase verbindet die fachliche Logik des Angebotsprozesses mit einem wiederverwendbaren Datenprodukt und der KI-gestützten Dokumentenverarbeitung. Die entscheidende Gestaltungsaufgabe liegt in dieser Verbindung: Welche Informationen braucht der Vertrieb, wie werden sie fachlich zugeordnet und wie entsteht daraus ein nachvollziehbarer Angebotsvorschlag? Damit steht nicht das Sprachmodell allein im Mittelpunkt, sondern die Übersetzung von Daten und Technologie in einen konkreten Vertriebsablauf.
Ich wünsche Ihnen viel Spaß beim Lesen des Blogbeitrags.
Das technische Setup: Die strategische Rolle der SAP BDC Komponenten
Wie gelangen Informationen aus einer PDF-Anfrage mit dem passenden Geschäftskontext in einen Angebotsvorschlag? Dafür braucht der Workflow eine Verbindung zwischen operativen Geschäftsdaten, unstrukturierten Dokumenten und KI-gestützter Verarbeitung. Bevor wir die beiden Teilprozesse betrachten, zeigen wir, welche Aufgabe die einzelnen Komponenten in diesem Zusammenspiel übernehmen.
Für die Umsetzung der beiden Use Cases ist eine Architektur erforderlich, die belegbasierte Stamm- und Bewegungsdaten aus operativen SAP-ERP – und CRM-Systemen samt Businesskontext (Semantik) mit externen non-SAP-Daten unterschiedlicher Formate und Inhalte verbindet. Dabei muss in einem solchen System die Governance gewahrt bleiben, d. h., es muss sichergestellt werden, dass Daten unternehmensweit kontrolliert, nachvollziehbar, sicher und fachlich korrekt genutzt werden können. Ergänzende Data-Science-Funktionalitäten ermöglichen es, aus den SAP-Daten im Zusammenspiel mit non-SAP-Daten zusätzliche Erkenntnisse abzuleiten und die neuen datengetriebene Geschäftsprozesse zu entwickeln. Die technische Grundlage dafür bildet die SAP Business Data Cloud, kurz BDC.
Unter dem Dach dieser Data Fabric greifen u.a. folgende Komponenten ineinander:
SAP Datasphere (DSP) und SAP BW/4HANA PCE (BW/4) bilden die strukturierte, semantisch abgesicherte Geschäftsdatenbasis. Sie stellen geprüfte Daten, fachlichen Kontext und wiederverwendbare Datenprodukte bereit.
SAP Databricks ergänzt die semantisch abgesicherte Geschäftsdatenbasis um eine skalierbare Lakehouse-Plattform mit zwei zentralen Kompetenzfeldern: Zum einen ermöglicht sie die Ablage, Verwaltung und Verarbeitung strukturierter, semi- und unstrukturierter Daten. Zum anderen stellt sie integrierte Funktionen für Data Engineering, Machine Learning sowie generative und agentische KI bereit.
SAP Analytics Cloud (SAC) und out-of-the-box bereitgestellte Chatbots wie Joule (SAP BTP) oder Genie (Databricks) machen die in der BDC bereitgestellten Daten in Form von Reporting- und Planungsanwendungen oder durch eine Promptabfrage nutzbar.
Die SAP Business Data Cloud bildet den übergreifenden Rahmen, in dem die einzelnen Bausteine konsistent zusammenspielen. Dabei geht es nicht um die Frage, ob SAP BW/4, Datasphere oder SAP Databricks eingesetzt werden. Entscheidend ist ihr Zusammenspiel: Vertrauenswürdige Geschäftsdaten (Trusted Data) aus der SAP-Welt werden mit modernen Data- und KI-Funktionen verbunden. Für Unternehmen ist diese Einordnung zentral: Bestehende Investitionen und gewachsene Analytics-Landschaften müssen nicht ersetzt werden! Vielmehr entsteht ein Entwicklungspfad, der vorhandene SAP-Komponenten und unternehmensinterne Kompetenzen nutzt und zugleich den Weg für moderne Data- und KI-Szenarien öffnet.
Dabei hilft das Lakehouse in der BDC. Es ist mehr als eine technische Ablage für große Datenmengen. Es ist der Ort, an dem strukturierte Geschäftsdaten, unstrukturierte Dokumenteninhalte, abgeleitete Merkmale sowie Ergebnisse aus Data Engineering, Machine Learning und generativer KI gemeinsam verarbeitet werden können. Für den Sales Agent bedeutet das: Angebotsanfragen, historische Angebotsdaten, operative SAP-Informationen und KI-basierte Erkenntnisse werden in einem gemeinsamen Kontext nutzbar. So entstehen Zusammenhänge, die in klassischen Berichten kaum sichtbar wären, aber für operative Entscheidungen im Angebotsprozess unmittelbar relevant sind.
Wer tiefer in das Thema SAP Business Data Cloud eintauchen möchte, findet in unseren weiterführenden Blogbeiträgen wertvolle Einblicke, wie zum Beispiel: Datenpotenziale heben, KI nutzbar machen: Wie die SAP Business Data Cloud (BDC) das Datenmanagement transformiert
Teilprozess 1: Angebotsagent – vom RFQ automatisiert zum Angebot
Im ersten Teil dieser Blogreihe betrachten wir den auf der linken Seite der Abbildung dargestellten Teilprozess 1. Schritt für Schritt zeigen wir, wie ein agentischer Workflow eine eingehende Angebotsanfrage (Request for Quotation, RFQ) verarbeitet, relevante Informationen extrahiert, diese mit Geschäfts- und Stammdaten anreichert und daraus automatisiert einen fundierten Angebotsvorschlag erstellt:
Schritt 1: Dokument mit der Angebotsanfrage einlesen
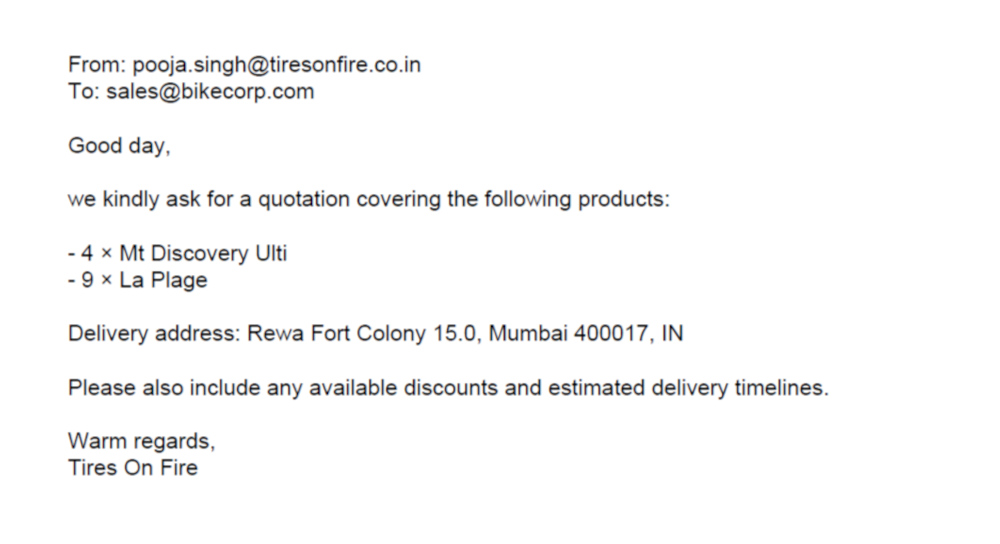
Der Prozess beginnt mit dem Einlesen der Angebotsanfrage (RfQ) als PDF-Dokument. Der Kunde „Tires on Fire” fragt ein Angebot für vier Stück Mountain Bike „Discovery Ulti“ und neun Stück „La Plage“ an:
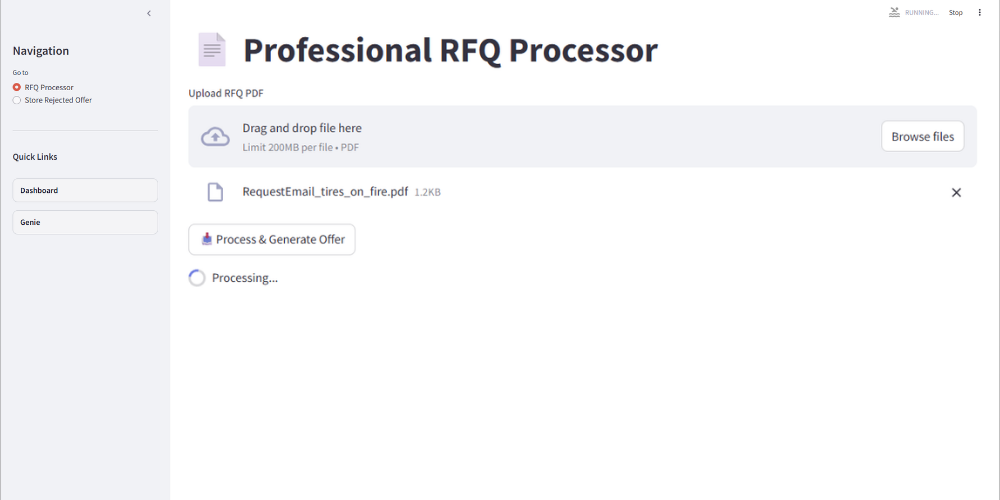
Das RfQ-PDF-Dokument wird nicht direkt „unsichtbar“ im Hintergrund verarbeitet, sondern über eine einfache Weboberfläche ins SAP Databricks hochgeladen. Diese Oberfläche wurde mit Streamlit, einem Framework für die Entwicklung von Webanwendungen mit Python, erstellt. Wir nutzen dazu den RfQ-Prozessor (Modus) dieser Anwendung:
Im produktiven Betrieb würde das Einlesen der RFQ-Dokumente idealerweise nicht wie in unserem Showcase manuell über eine interaktive Webanwendung erfolgen, sondern über einen standardisierten Eingangskanal. Eingehende Angebotsanfragen könnten beispielsweise aus einem zentralen E-Mail-Postfach, einem CRM-System, einem Kundenportal oder einem Dokumentenmanagementsystem automatisiert übernommen werden. Die PDF-Dokumente würden dabei in einer definierten „Landing Zone“ im Lakehouse abgelegt, mit Metadaten wie Kunde, Eingangsdatum, Quelle und Bearbeitungsstatus angereichert und anschließend automatisiert für die weitere Verarbeitung bereitgestellt werden.
Schritt 2: Extraktion der relevanten Informationen des RFQ
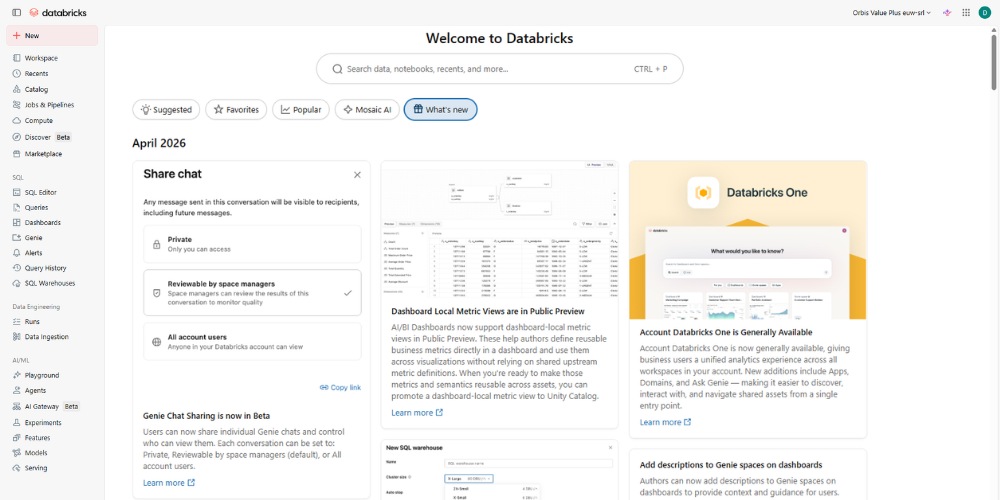
Databricks stellt Werkzeuge für SQL-Analysen, professionelles Data Engineering sowie fortgeschrittene KI- und Machine-Learning-Szenarien bereit. Die dafür benötigten Daten und Artefakte werden im Unity Catalog zentral und strukturiert verwaltet:
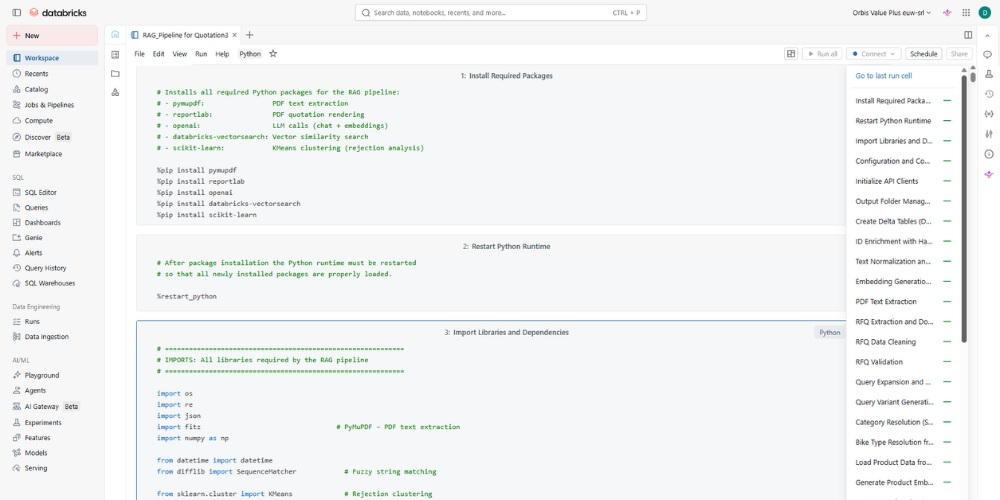
Die in Databricks durchgeführten Verarbeitungsschritte und Anweisungen werden dort in sogenannten Notebooks festgehalten. Ein Notebook ist eine interaktive Arbeitsumgebung, in der Code, Kommentare und Ergebnisse zusammengeführt werden. Dadurch lassen sich Datenverarbeitung, Analyse und KI-gestützte Extraktion nachvollziehbar entwickeln, dokumentieren und ausführen:
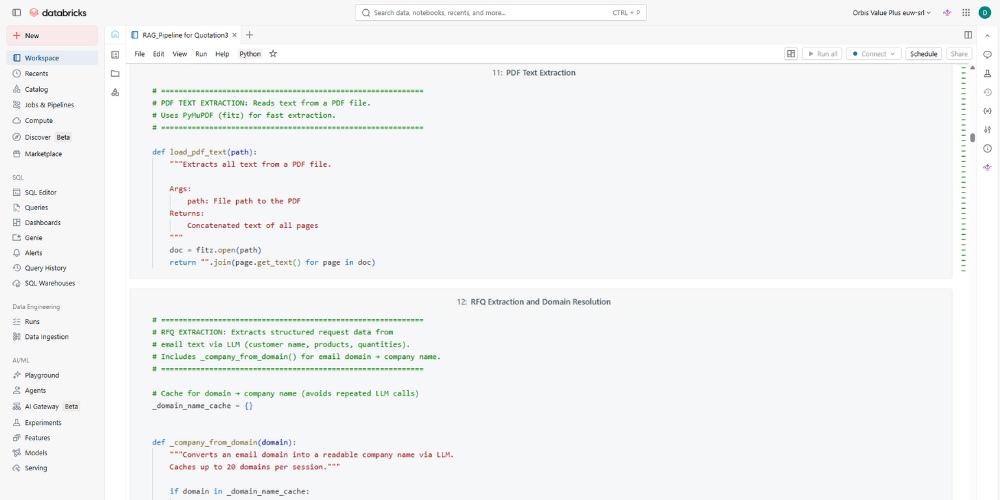
Im zweiten Schritt wird mittels eines entsprechenden Prompts ein Large Language Model (LLM) angestoßen, das den Inhalt des PDF-Dokuments analysiert und relevante Entitäten wie Kunde, Material, Mengen etc. identifiziert:
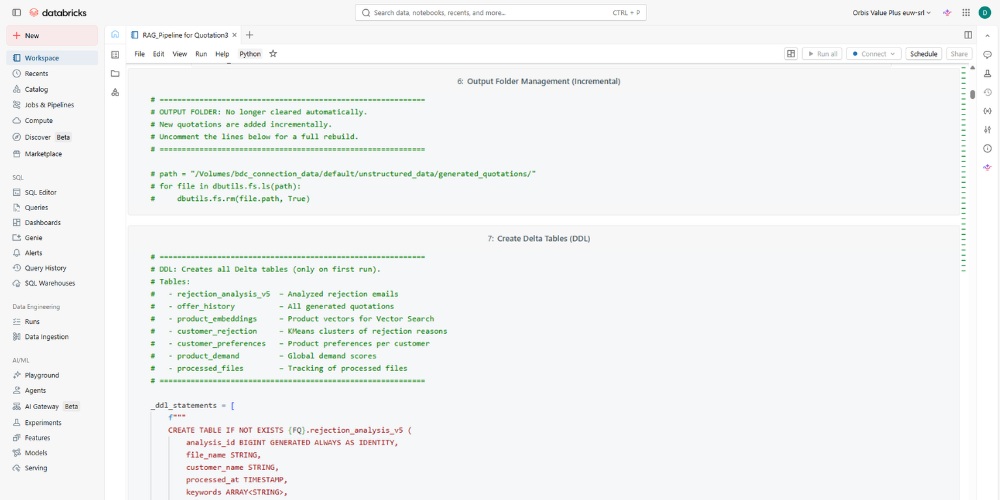
Danach werden diese Informationen in strukturierter Form in entsprechenden Tabellen im Unity Catalog abgelegt, die vorher eigens dafür erzeugt wurden:
Schritt 3: Identifikation des Kunden
Im nächsten Schritt wird der aus dem PDF extrahierte Kundenname einem Kundenstammsatz in den realen Geschäftsdaten der SAP Datasphere zugeordnet. Grundlage für diese „Matching“ ist die gemeinsame Datenbasis von Databricks und SAP Datasphere innerhalb der BDC. Relevante Stamm- und Bewegungsdaten aus dem ERP-Vertrieb – darunter Kunden- und Materialstammdaten sowie Verkaufsbelege und Rechnungsinformationen – wurden in die SAP Datasphere geladen und im Datenprodukt „Sales History“ gebündelt:
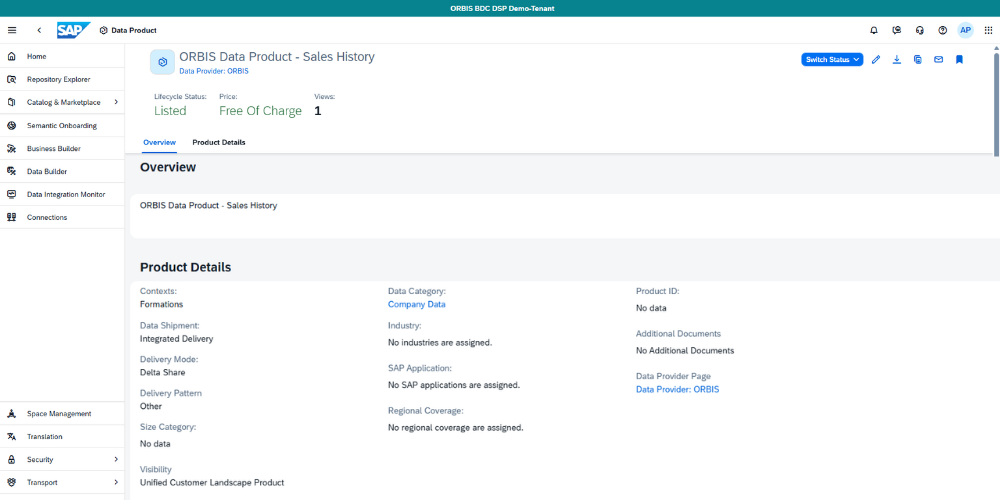
Ein Datenprodukt bündelt innerhalb der SAP Datasphere fachlich zusammengehörige Daten in einer definierten, verlässlichen und wiederverwendbaren Form, die Voraussetzung für die gemeinsame Nutzung mit einem Data Lakehouse wie Databricks ist. Es beschreibt nicht nur, welche Daten bereitgestellt werden, sondern auch deren Bedeutung, Struktur, Nutzungskontext und Qualität. Gerade im Zusammenspiel von SAP Datasphere und Databricks ist das entscheidend: Die SAP Datasphere stellt semantisch abgesicherte Geschäftsdaten als Datenprodukt bereit, während Databricks diese Daten in Data-Engineering-Szenarien weiterverarbeiten kann. Die meisten von Ihnen kennen sicherlich die klassischen Artefakte wie CDS-Views, CompositeProvider und Analytical Views. Diese Objekte sind allerdings primär lediglich Modellierungs- bzw. Zugriffsschichten. Ein Datenprodukt dagegen ist eine fachlich kuratierte, konsumierbare und wiederverwendbare Dateneinheit, die über die reine technische Modellierung hinausgeht:
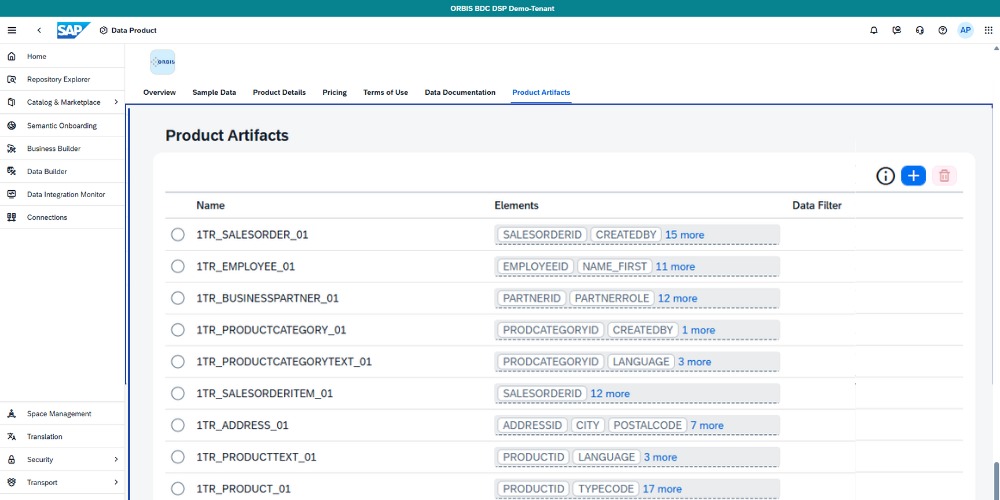
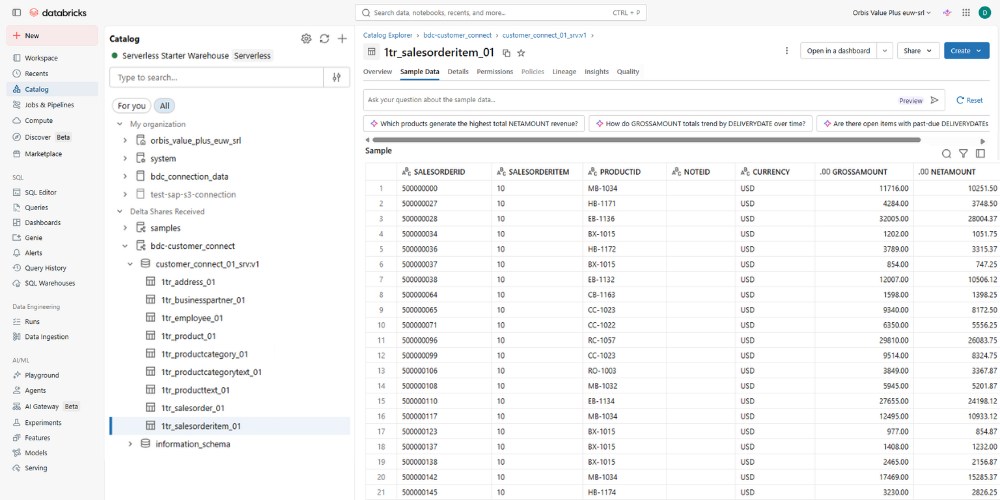
Über Zero-Copy Delta Sharing lassen sich Datenprodukte direkt in Databricks weiterverarbeiten, ohne die zugrunde liegenden Daten physisch zu kopieren oder zu replizieren. Sie verbleiben in der SAP Datasphere und werden dort unter Einhaltung einer einheitlichen Governance kontrolliert bereitgestellt. Dadurch entfallen weitgehend redundante Datenbestände, zusätzliche ETL-Prozesse und aufwendige Synchronisationen.
Für KI- und Agentenszenarien ist diese vertrauenswürdige Datenbasis entscheidend. Semantisch angereicherte Datenprodukte erhalten Business-Kontext, Hierarchien, Kennzahlenlogik und fachliche Bedeutung. Damit greift unser RfQ Workflow nicht nur auf „technisch verfügbare Daten“ zu, sondern auf Informationen, die fachlich kuratiert, aktuell und korrekt interpretierbar sind. Das macht nochmal deutlich, dass der Einsatz von KI kein isoliertes Technologieprojekt ist, sondern dass eine übergreifenden Datenstrategie Teil davon sein muss:
Schritt 4: Ermitteln der Produkte und Preise für das Angebot
In Databricks werden über das Data Product „Sales History“ auch Produkttexte, Produktkategorien und Preise bereitgestellt. Dazu zählen sowohl Standardpreise als auch kundenindividuelle Produkt- und Preishistorien aus früheren Angeboten, Verkaufs- und Rechnungsbelegen:
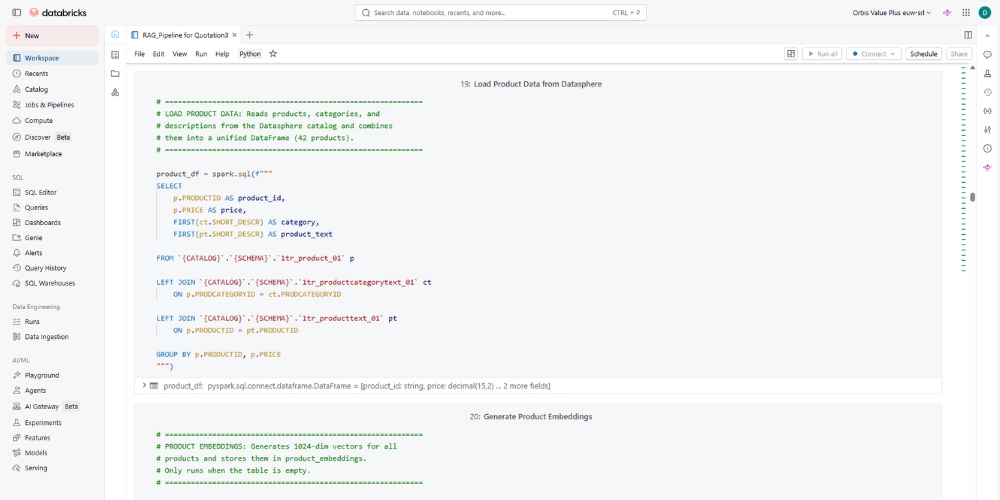
Weil die im RfQ genannten Produkte nicht zwangsläufig über exakte Artikelnummern oder identische Produktbezeichnungen in der Datenbasis auffindbar sind, werden sogenannte Embeddings genutzt. Embeddings sind numerische Repräsentationen von Texten, Produkten oder Dokumentinhalten. Ein Produkttext wie „Mountain Bike Discovery Ulti“, eine technische Beschreibung oder eine kundenspezifische Formulierung aus einer Anfrage wird dabei in einen Vektor, also eine Liste von Zahlen, übersetzt. Die aus den Produktinformationen erzeugten Embeddings werden in Databricks in einer vom Unity Catalog verwalteten Tabelle gespeichert und zusammen mit den zugehörigen Metadaten über einen Vector-Search-Index für die semantische Produktsuche bereitgestellt. Der Vektorraum ist dabei kein separater physischer Speicherort, sondern ergibt sich aus der Gesamtheit der im Index enthaltenen Embedding-Vektoren. Ähnliche Inhalte liegen in diesem Vektorraum nahe beieinander, auch wenn sie sprachlich unterschiedlich formuliert sind. Die anschließende Vektorsuche vergleicht den Vektor der Kundenanfrage mit den Vektoren der Produktinformationen aus der Sales History und ermittelt diejenigen Produkte, die semantisch am besten passen. Dadurch kann der KI-Mechanismus auch dann passende Materialien und Produktvarianten identifizieren, wenn der Kunde abgekürzte, unvollständige oder abweichende Bezeichnungen verwendet. Für die Preisfindung ist das besonders hilfreich, weil nach der Produktzuordnung nicht nur der passende Standardpreis, sondern auch kundenindividuelle Preis- und Angebotshistorien ähnlicher Produkte herangezogen werden können. So entsteht eine fundiertere Grundlage für den Angebotsvorschlag: Der KI-Workflow kombiniert die semantische Ähnlichkeit aus der Vektorsuche mit den strukturierten Preis-, Kunden- und Belegdaten aus der SAP Business Data Cloud.
Schritt 5 & 6: Erzeugen des Angebotstextes und des Angebots in PDF-Form
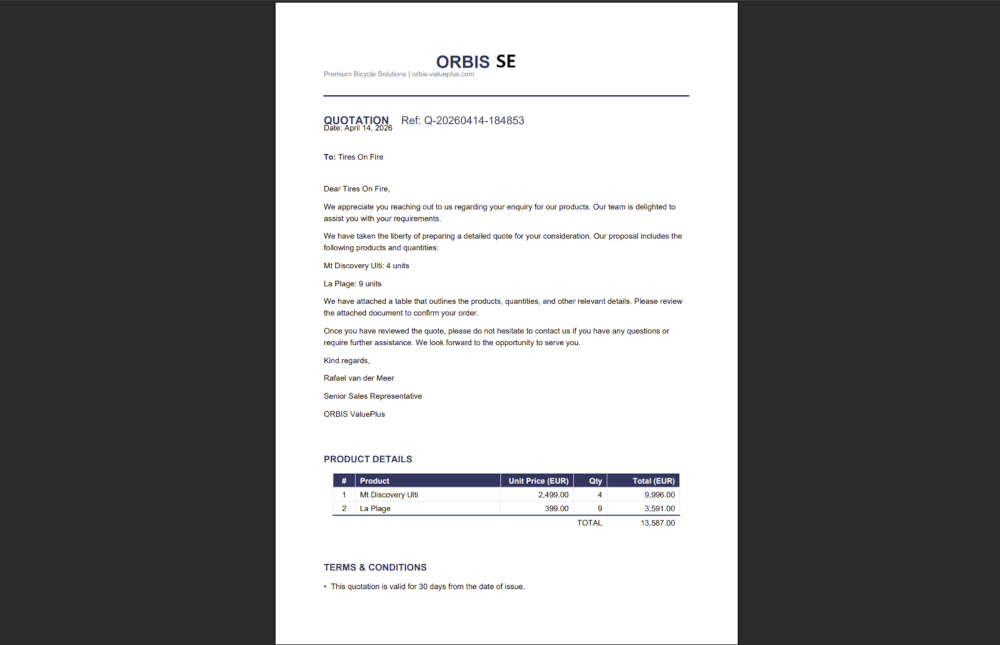
In den Schritten fünf und sechs erstellt ein LLM auf Basis der angebotsrelevanten Informationen den Angebotstext. Anschließend wird das Angebot mit ReportLab als PDF generiert, in der „Quotation Preview“ des RfQ-Prozessors der Streamlit-Anwendung aus Schritt 1 angezeigt und dort zum Download bereitgestellt. ReportLab ist eine Python-Bibliothek innerhalb von Databricks, mit der aus Texten, Daten und entsprechenden Layout-Elementen ein PDF-Dokument erzeugt werden kann:
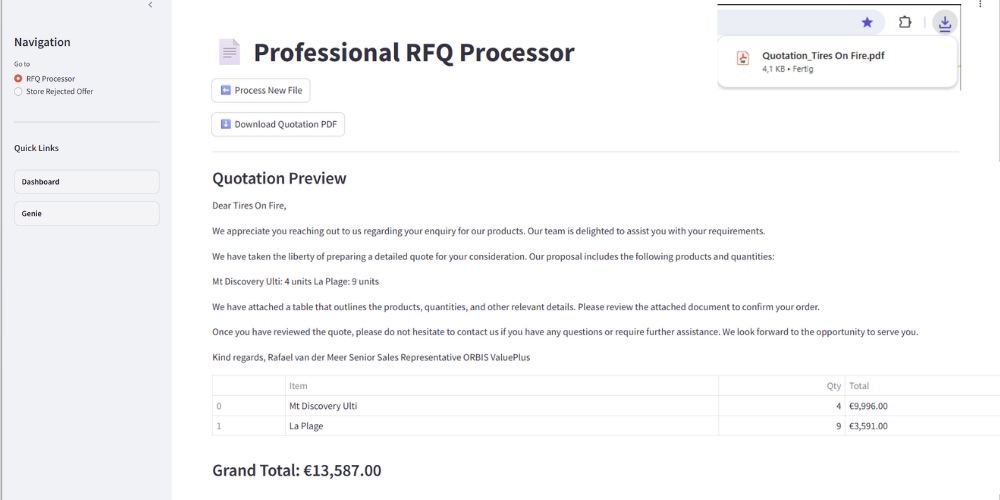
Mit der Erstellung des Angebots in PDF-Form ist Teilprozess 1 – die automatisierte Angebotserstellung durch den agentischen Workflow – abgeschlossen.
Spoiler: Merken Sie sich die vom System erzeugte Angebotsnummer Q-20260414-184853. Im zweiten Teil des Blogs wird uns diese Angebotsnummer wieder „über den Weg laufen“:
Fazit zu Teilprozess 1: Agentische Workflows in der SAP Business Data Cloud: Mit KI vom RfQ zum Angebot
Der erste Teil unseres Showcases zeigt, wie aus einer unstrukturierten Angebotsanfrage ein konkreter Angebotsvorschlag entstehen kann. Entscheidend ist dabei nicht eine einzelne KI-Funktion, sondern das Zusammenspiel der Komponenten innerhalb der SAP Business Data Cloud: Vertrauenswürdige und semantisch angereicherte Geschäftsdaten aus der SAP Datasphere werden mit den Data-Engineering- und KI-Funktionen von Databricks verbunden. So kann der KI-gestützte Workflow Inhalte aus dem RfQ extrahieren, Kunden und Produkte zuverlässig zuordnen, historische Preis- und Belegdaten einbeziehen und schließlich ein Angebot als PDF bereitstellen. Damit wird sichtbar, wie sich ein heute häufig manueller, zeitintensiver Prozess datenbasiert beschleunigen und gezielt unterstützen lässt.
Doch mit dem Versand eines Angebots endet der Lernprozess nicht. Was geschieht, wenn der Kunde ablehnt – und wie lassen sich die Gründe dafür strukturiert erfassen, analysieren und für künftige Vertriebsentscheidungen nutzbar machen? Genau hier setzt der zweite Teil dieser Blogreihe an. In zwei bis drei Wochen zeigen wir, wie ein KI-gestützer Workflow Kundenfeedback verarbeitet, wiederkehrende Absagemuster erkennt und die gewonnenen Erkenntnisse über SAP Datasphere, SAP Analytics Cloud und Joule in den Geschäftskontext zurückführt. Und auch das oben erzeugte Angebot mit der Nummer Q-20260414-184853 wird dabei erneut eine Rolle spielen.


